IA locale : la mémoire prime sur la puissance
Longtemps, on a choisi une carte graphique pour sa puissance de calcul. Pour faire tourner une IA sur ses propres données, c'est la quantité de mémoire qui décide — et souvent elle seule.
Ce qui a changé en 2026
L'année 2026 marque un tournant dans l'industrie de l'intelligence artificielle. Pendant longtemps, les performances des cartes graphiques étaient principalement évaluées selon leur puissance de calcul. Aujourd'hui, la capacité mémoire (VRAM) et la bande passante mémoire sont devenues des éléments tout aussi déterminants.
Cette évolution est directement liée à l'explosion des modèles d'IA, mais également à une tendance forte : de plus en plus d'entreprises souhaitent déployer l'IA en interne afin de conserver la maîtrise de leurs données sensibles.
L'IA d'entreprise change les règles du jeu
Depuis plusieurs années, les entreprises utilisent des services d'IA hébergés dans le cloud. Cependant, de nombreux secteurs comme la finance, la santé, l'industrie, la défense ou encore les services juridiques se montrent de plus en plus prudents concernant le partage de leurs données avec des plateformes externes.
Les raisons sont multiples :
- Protection des données confidentielles.
- Respect des réglementations sur la confidentialité.
- Réduction des risques de fuite d'informations stratégiques.
- Contrôle total sur les modèles et les infrastructures.
- Limitation de la dépendance envers les fournisseurs de services cloud.
Des infrastructures d'IA privées
Cette tendance favorise le développement d'infrastructures d'IA privées, hébergées directement dans les centres de données des entreprises ou exécutées localement sur des stations de travail équipées de GPU performants.
Les fournisseurs de technologies IA soulignent que l'exécution locale permet notamment de préserver la confidentialité des données, de réduire la latence et de conserver un contrôle complet sur les traitements.
Pourquoi la mémoire est devenue plus importante que la puissance brute
Contrairement aux applications traditionnelles, les modèles d'IA modernes doivent stocker d'énormes volumes de données directement dans la mémoire de la carte graphique.
Cette mémoire contient :
- Les poids du modèle.
- Les activations intermédiaires.
- Les caches utilisés lors de l'inférence.
- Les données nécessaires à l'entraînement.
Combien de mémoire pour quel modèle ?
Lorsque ces données ne tiennent pas dans la VRAM, elles sont déplacées vers la mémoire système, ce qui provoque une baisse drastique des performances. Dans certains cas, le modèle devient tout simplement inutilisable.
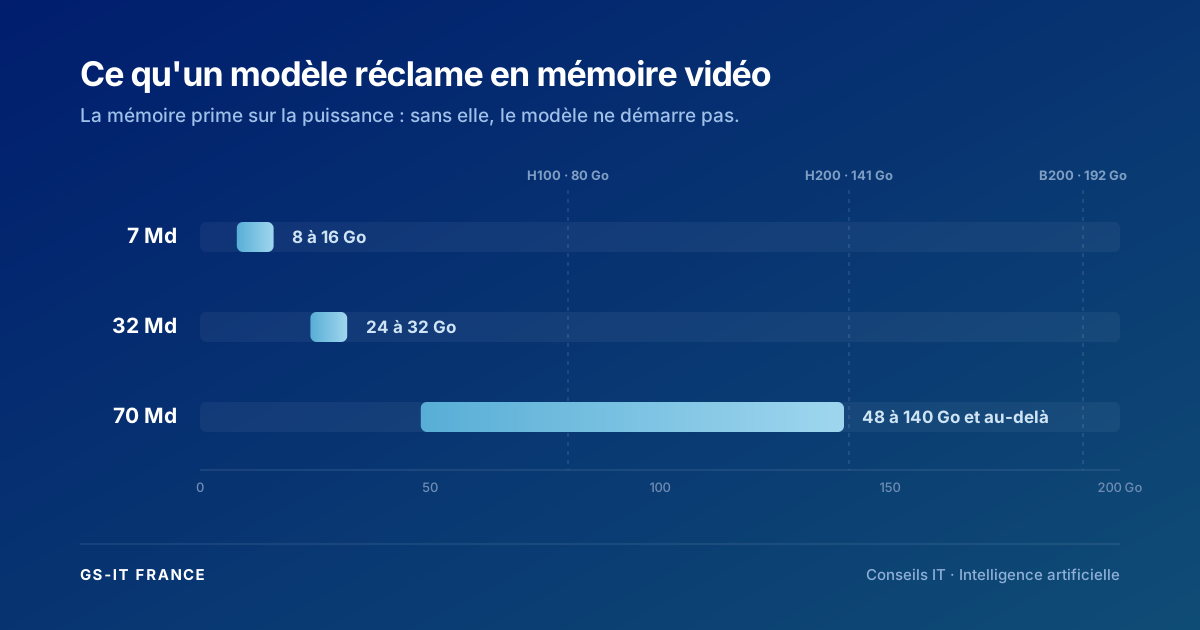
Les experts considèrent aujourd'hui que la VRAM est souvent le premier facteur limitant pour les projets d'IA. Les ordres de grandeur, selon la taille du modèle :
- Un modèle de 7 milliards de paramètres nécessite généralement entre 8 et 16 Go de VRAM.
- Un modèle de 32 milliards de paramètres requiert souvent 24 à 32 Go.
- Les modèles de 70 milliards de paramètres peuvent nécessiter entre 48 et plus de 140 Go selon la précision utilisée.
La montée en puissance des grands modèles internes
Pour une entreprise souhaitant héberger son propre assistant IA ou analyser ses documents internes sans les envoyer vers un service externe, disposer d'une grande quantité de mémoire vidéo devient donc une nécessité.
Les entreprises ne se contentent plus de simples chatbots. Elles développent des assistants capables d'accéder à leur base documentaire, leurs procédures internes, leurs contrats, leurs données clients et leurs rapports financiers.
Ces systèmes reposent souvent sur des modèles de langage spécialisés qui doivent être exécutés localement pour des raisons de confidentialité. Or plus le modèle est avancé, plus son besoin en mémoire augmente. C'est pourquoi les directions informatiques privilégient désormais des GPU dotés de 32 Go, 48 Go, 80 Go ou davantage de mémoire, plutôt que des cartes uniquement optimisées pour la puissance de calcul.
La révolution de la mémoire HBM
Face à ces besoins croissants, l'industrie s'est tournée vers la mémoire HBM (High Bandwidth Memory), beaucoup plus rapide que la mémoire graphique traditionnelle. Les accélérateurs IA de centre de données les plus récents illustrent cette tendance :
- NVIDIA H100 : 80 Go de HBM3.
- NVIDIA H200 : 141 Go de HBM3e.
- NVIDIA Blackwell B200 : 192 Go de HBM3e.
Et concrètement, sur une station de travail ?
Les accélérateurs ci-dessus équipent des centres de données, pas des bureaux. Sur une station de travail, l'équivalent actuel est la carte professionnelle NVIDIA RTX PRO 6000 Blackwell et ses 96 Go de mémoire GDDR7 — trois fois la mémoire d'une RTX 5090, qui plafonne à 32 Go.
C'est précisément l'écart qui compte : à puissance de calcul comparable, seule la carte disposant de la mémoire suffisante fera tourner le modèle. L'autre le refusera, ou le fera ramer au point de le rendre inutilisable.
C'est pour cette raison qu'une station IA se dimensionne à partir du modèle que vous comptez faire tourner, et non l'inverse. La question à se poser avant l'achat n'est pas « quelle est la carte la plus puissante de mon budget ? » mais « quelle taille de modèle dois-je héberger, et sur combien de temps ? ».
Une mémoire devenue le principal goulot d'étranglement du marché
La demande mondiale en IA est telle que la mémoire HBM est devenue l'une des ressources les plus recherchées de l'industrie des semi-conducteurs.
Selon plusieurs analyses du marché, la production de mémoire HBM des principaux fabricants est largement réservée à l'avance par les grands acteurs de l'IA. Les besoins des hyperscalers, des États et des grandes entreprises ont créé une tension sans précédent sur l'approvisionnement en mémoire avancée.
Cette situation montre que le défi majeur de l'IA n'est plus seulement de produire des processeurs plus puissants, mais également de fournir suffisamment de mémoire pour alimenter ces systèmes. Pour un acheteur, elle a une conséquence pratique : les configurations très dotées en mémoire s'anticipent, elles ne se trouvent pas en stock du jour au lendemain.
Ce qu'il faut retenir
En 2026, la mémoire est devenue l'élément stratégique des cartes graphiques destinées à l'intelligence artificielle. L'essor des modèles toujours plus volumineux et la volonté croissante des entreprises de conserver leurs données en interne accélèrent la demande pour des GPU disposant de capacités mémoire importantes.
Dans ce contexte, les organisations ne cherchent plus simplement la carte graphique la plus rapide. Elles recherchent avant tout celle qui leur permettra d'exécuter localement leurs modèles d'IA, de protéger leurs informations stratégiques et de garder le contrôle total sur leurs données. La VRAM et la mémoire HBM sont ainsi devenues des ressources aussi précieuses que la puissance de calcul elle-même.
Pourquoi c'est utile
Parce qu'une station achetée pour sa puissance mais trop juste en mémoire ne fera pas tourner le modèle : elle sera inutilisable pour l'usage prévu.
Un projet ou une question ?
Nos experts vous répondent et vous proposent un devis en 2 h max.
Parler à un expert GS-IT